Come funziona l’intelligenza artificiale: i 5 pezzi chiave che devi conoscere
Capire come funziona l’intelligenza artificiale nel 2026 non richiede una laurea in informatica. Richiede conoscere cinque idee pubblicate tra il 2017 e il 2022, tutte documentate in paper accademici accessibili a chiunque. La parte nuova non è nessuna di queste idee presa singolarmente: è quanto bene stanno iniziando a funzionare tutte insieme.
Questa guida ti porta attraverso ciascuno dei cinque componenti fondamentali dell’intelligenza artificiale moderna, nell’ordine in cui sono stati pubblicati. Per ogni pezzo troverai: cosa fa, perché conta, quale errore di comprensione evitare e come si collega agli altri. Alla fine saprai leggere la struttura dell’intelligenza artificiale che usi ogni giorno.
Ho ricostruito questa timeline partendo direttamente dai paper originali. Il principio è semplice: prima di usare uno strumento, conviene capire come è fatto.
Perché servono esattamente cinque pezzi per capire come è fatta l’AI
L’intelligenza artificiale di oggi non è comparsa all’improvviso. È il montaggio progressivo di cinque innovazioni distinte, ciascuna pubblicata in un paper accademico tra il 2017 e il 2022.
Ecco la sequenza:
- 2017 — Transformer → scala
- 2020 — RAG → conoscenza
- 2022 — RLHF → allineamento
- 2022 — Chain of Thought → reasoning
- 2022 — ReAct → azione
Ognuno di questi elementi base dell’AI risolve un problema specifico che il precedente lasciava aperto. Togline uno e il sistema che conosci oggi non funziona. Questa non è una lista arbitraria: è la struttura dell’intelligenza artificiale contemporanea, ricostruita a partire dalle pubblicazioni scientifiche che l’hanno resa possibile.
Pezzo 1. Transformer: l’architettura che permette di scalare
Il Transformer è l’architettura che ha reso possibile elaborare il linguaggio su scala. Pubblicato nel 2017 da Vaswani et al. nel paper “Attention Is All You Need”, ha cambiato le regole del gioco.
La svolta non è soltanto il meccanismo di attention. Il modello abbandona ricorrenza e convoluzioni come struttura principale e può elaborare le sequenze in modo molto più parallelizzabile. Questo è il passaggio tecnico che renderà possibile scalare i modelli fino ai Large Language Model di oggi.
Cosa fa concretamente
Il Transformer prende una sequenza di testo, calcola le relazioni tra ogni parola e tutte le altre nella sequenza, e produce una rappresentazione che cattura il contesto. Può farlo in parallelo, non parola per parola.
L’errore da evitare
Pensare che il Transformer sia “l’intelligenza” del sistema. Non lo è. È l’infrastruttura. Senza i quattro pezzi successivi, un Transformer da solo produce testo statisticamente plausibile ma non necessariamente utile, accurato o allineato alle intenzioni di chi lo usa.
Pezzo 2. RAG: la conoscenza fuori dal modello
La conoscenza utile non deve stare tutta nei parametri del modello. Questa è l’idea fondamentale del RAG (Retrieval-Augmented Generation), pubblicata nel 2020 da Lewis et al. nel paper “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”.
Il RAG affianca al modello una memoria esterna: recupera le informazioni rilevanti quando servono e le usa per costruire la risposta. Se oggi colleghi un sistema di intelligenza artificiale ai documenti della tua azienda, una parte della storia parte da qui.
Come si distingue dal fine-tuning
Il RAG non cambia il modello. Al momento della domanda recupera i documenti pertinenti e li usa per rispondere. Il fine-tuning invece modifica i pesi del modello con un nuovo addestramento. Il RAG è più adatto a conoscenze che cambiano spesso o che devono restare citabili.
L’errore da evitare
Credere che il RAG elimini le imprecisioni. Il modello può ancora ignorare o distorcere le informazioni recuperate. La qualità della risposta dipende dalla qualità dei documenti e dalla capacità del sistema di selezionare quelli giusti.
Pezzo 3. RLHF: più parametri, da soli, non bastano
Il RLHF (Reinforcement Learning from Human Feedback) è il meccanismo che allinea il modello alle intenzioni delle persone. Il paper di riferimento è “Training language models to follow instructions with human feedback”, pubblicato nel 2022 da Ouyang et al. (InstructGPT).
Il dato più significativo del paper: nelle valutazioni umane, InstructGPT da 1,3 miliardi di parametri veniva preferito a GPT-3 da 175 miliardi. Più grande non significa automaticamente migliore. L’allineamento conta più della dimensione.
Come funziona il processo
Delle persone confrontano più risposte generate dal modello e indicano la migliore. Quei giudizi addestrano un modello di ricompensa, e il modello principale viene ottimizzato su di esso. Questo avviene in fase di addestramento, non durante le conversazioni.
L’errore da evitare
Pensare che il modello “impari” dalle tue chat in tempo reale. L’RLHF è un processo di addestramento che avviene prima che il modello arrivi a te. Durante una conversazione, il modello non cambia.
Sottolineo spesso questo punto nella mia attività di formazione: capire la differenza tra addestramento e utilizzo è il primo passo per interagire con l’intelligenza artificiale in modo consapevole.
Pezzo 4. Chain of Thought: conta anche il processo
Il Chain of Thought (CoT) dimostra che far produrre al modello dei passaggi intermedi può migliorare le performance su problemi che richiedono reasoning complesso. Il paper è “Chain-of-Thought Prompting Elicits Reasoning in Large Language Models”, pubblicato nel 2022 da Wei et al.
Diventa centrale non soltanto la risposta finale, ma il processo che permette di arrivarci.
Cosa cambia nella pratica
Senza CoT, il modello salta direttamente alla risposta. Con CoT, articola i passaggi intermedi. Questo rende il ragionamento verificabile e spesso più accurato, specialmente su problemi matematici, logici o multi-step.
Molti modelli del 2026 sono addestrati a ragionare per passaggi prima di rispondere, anche senza che glielo si chieda esplicitamente. Chiedere i passaggi resta utile su problemi complessi e per poter verificare il ragionamento.
L’errore da evitare
Assumere che i passaggi intermedi siano sempre corretti. Il modello può produrre catene di ragionamento che sembrano logiche ma contengono errori. La verificabilità è un vantaggio, ma la verifica resta responsabilità di chi legge.
Questo è un punto centrale nel mio approccio alla metacognizione: l’interazione con lo strumento non sostituisce il pensiero critico, lo allena.
Pezzo 5. ReAct: quando il reasoning diventa azione
Il ReAct (Reasoning + Acting) è il pezzo che collega il ragionamento all’azione concreta. Pubblicato nel 2022 da Yao et al. nel paper “ReAct: Synergizing Reasoning and Acting in Language Models”, formalizza il ciclo in cui il modello alterna ragionamento e azioni con strumenti esterni.
Se oggi vedi un agente cercare informazioni, usare un tool e poi decidere il passaggio successivo, il principio è già qui.
Il ciclo pensa-agisci-osserva
Il modello:
- Pensa — decide cosa fare sulla base del contesto
- Agisce — usa uno strumento esterno (ricerca, API, codice)
- Osserva — valuta il risultato
- Corregge — aggiorna il piano e ripete
Questo è lo schema concettuale su cui si basano gli agenti del 2026: sistemi capaci di operare in autonomia su compiti multi-step.
L’errore da evitare
Confondere autonomia con infallibilità. Un agente basato su ReAct può sbagliare un’azione, interpretare male un risultato o entrare in loop. La supervisione umana resta parte del design, non un’opzione.
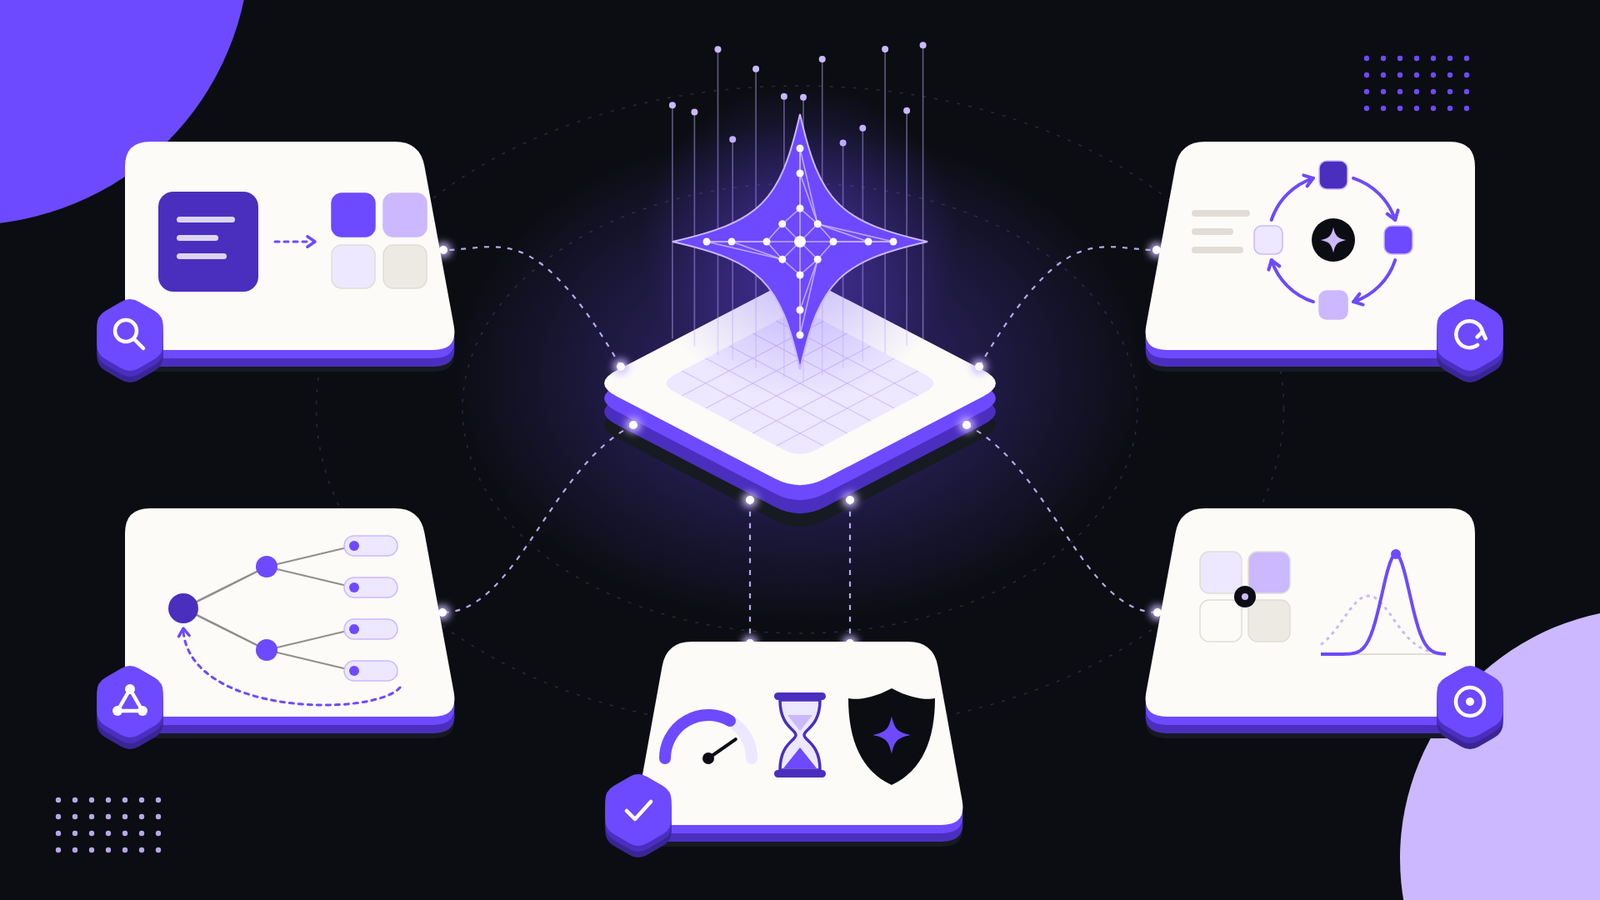
Come i cinque pezzi funzionano insieme: la struttura dell’intelligenza artificiale
Ora che conosci i singoli componenti fondamentali, ecco come si combinano nella struttura dell’intelligenza artificiale che usi ogni giorno:
- Il Transformer fornisce la capacità di elaborare linguaggio su scala
- Il RAG aggiunge conoscenza esterna aggiornata e specifica
- L’RLHF allinea le risposte alle intenzioni umane
- Il Chain of Thought struttura il ragionamento in passaggi verificabili
- Il ReAct trasforma quel ragionamento in azioni concrete
Oggi parliamo di agenti, reasoning model, tool use e memoria. Molte delle idee fondamentali, però, erano già state pubblicate anni fa. La parte nuova è quanto bene stanno iniziando a funzionare tutte insieme.
Questa timeline, a partire dai paper originali su arXiv, ridimensiona l’idea che l’intelligenza artificiale sia apparsa dal nulla. È un processo incrementale, documentato e comprensibile.
Come verificare di aver compreso davvero come funziona l’intelligenza artificiale
Per sapere se hai interiorizzato i cinque pezzi chiave dell’intelligenza artificiale, prova questo esercizio. Prendi un qualsiasi sistema che usi quotidianamente e chiediti:
- Quale architettura elabora il linguaggio? (Transformer)
- Da dove arriva la conoscenza specifica? (RAG o parametri?)
- Come è stato allineato alle intenzioni umane? (RLHF o varianti)
- Mostra i passaggi del ragionamento? (Chain of Thought)
- Può compiere azioni autonome? (ReAct)
Se riesci a rispondere a queste cinque domande per lo strumento che stai usando, hai una mappa operativa della struttura dell’intelligenza artificiale. Non devi conoscere ogni dettaglio tecnico. Devi sapere quali pezzi ci sono, cosa fanno e dove possono fallire.
È esattamente il principio alla base dell’Umanesimo Tecnologico che porto avanti: la soluzione non è lo strumento, è chi diventi imparando a orientarlo.
Proprio per sbloccare davvero le possibilità che ci apre l’intelligenza artificiale dobbiamo imparare a ripensare anche il nostro modo di lavorare.
Il 26 novembre, insieme ad Alessandra Gonzato, ti aspetto ad Algoritmi Invisibili, il webinar gratuito in cui scoprirai come individuare i processi da migliorare, cosa delegare all’AI e come iniziare a dirigerla.
Iscriviti gratuitamente —> QUI